

Категории магазина бьются за самые конкурентные запросы, а основной спрос живёт «этажом ниже»: «холодильник no frost с нижней морозилкой», «белые кроссовки nike 42». На такие запросы отвечают страницы фильтров и теговые страницы — и именно их либо не делают вовсе, либо делают так, что каталог порождает миллионы дублей. Разбираем, как спроектировать SEO-фильтры интернет-магазина на этапе разработки: какие комбинации открывать для индексации, какие закрывать и почему ошибка в этой архитектуре стоит месяцев переделок.
В этой статье 6
Откуда берётся трафик, который магазины теряют
Спрос в товарной нише устроен как длинный хвост. Верхушка вроде «купить холодильник» молодому магазину недоступна годами. А ниже лежат тысячи низкочастотных запросов с конкретикой: бренд, цвет, материал, назначение. По отдельности каждый даёт единицы визитов, в сумме — сопоставимо с категорией, а конверсия выше: человек, который ищет «диван угловой раскладной серый», уже знает, чего хочет.
Проблема в том, что на такой запрос в каталоге обычно нет посадочной страницы. Есть категория «Диваны» и фильтр, который живёт только как состояние на JavaScript: галочки щёлкаются, список товаров меняется, адрес — нет. Для поисковика такой выборки не существует. «Умный фильтр» в SEO-смысле — это фильтр, у которого отобранные комбинации получают собственные адреса, метатеги и место в структуре сайта. Не все комбинации — отобранные.
Фильтры, фасеты и теги: в чём разница
Терминология плавает, поэтому зафиксируем. Страница фильтра (фасетная страница) создаётся автоматически из параметров товаров: «Категория + бренд», «Категория + цвет». Теговая страница — подборка, собранная вручную под спрос, который не выражается параметрами: «подарки до 5 000 ₽», «для маленькой кухни», «для начинающих». Механика разная, роль одна: и то и другое — посадочные страницы под средне- и низкочастотные запросы.
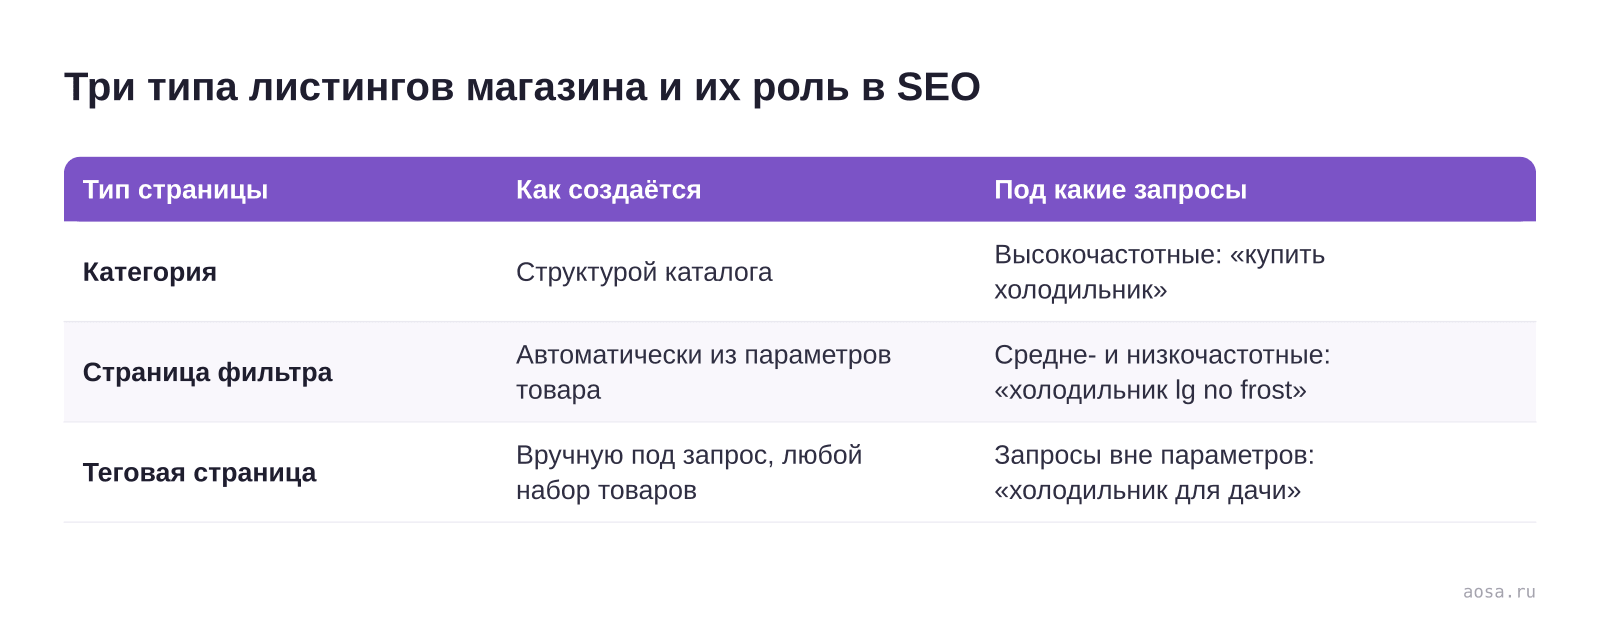
Три типа листингов магазина и их роль в SEO
- Тип страницы: Категория
- Как создаётся: Структурой каталога
- Под какие запросы: Высокочастотные: «купить холодильник»
- Тип страницы: Страница фильтра
- Как создаётся: Автоматически из параметров товара
- Под какие запросы: Средне- и низкочастотные: «холодильник lg no frost»
- Тип страницы: Теговая страница
- Как создаётся: Вручную под запрос, любой набор товаров
- Под какие запросы: Запросы вне параметров: «холодильник для дачи»
Текст схемы и все данные
Три типа листингов магазина и их роль в SEO
- Тип страницы: Категория
- Как создаётся: Структурой каталога
- Под какие запросы: Высокочастотные: «купить холодильник»
- Тип страницы: Страница фильтра
- Как создаётся: Автоматически из параметров товара
- Под какие запросы: Средне- и низкочастотные: «холодильник lg no frost»
- Тип страницы: Теговая страница
- Как создаётся: Вручную под запрос, любой набор товаров
- Под какие запросы: Запросы вне параметров: «холодильник для дачи»
| Тип страницы | Как создаётся | Под какие запросы |
|---|---|---|
| Категория | Структурой каталога | Высокочастотные: «купить холодильник» |
| Страница фильтра | Автоматически из параметров товара | Средне- и низкочастотные: «холодильник lg no frost» |
| Теговая страница | Вручную под запрос, любой набор товаров | Запросы вне параметров: «холодильник для дачи» |
Теговые страницы — самый недооценённый элемент из трёх: они закрывают спрос, до которого фильтры не дотягиваются в принципе, потому что «для дачи» или «в подарок» не бывает свойством товара в карточке. Их немного, ими управляет контент-менеджер, а конкуренты без них отдают вам целые пласты выдачи.
Комбинаторный взрыв: как фильтр порождает миллионы дублей
Обратная сторона той же механики: открой все комбинации — и каталог превращается в генератор мусорных страниц. Каждое сочетание значений — отдельный URL, а число сочетаний растёт лавинообразно.
Что получает магазин, открывший всё подряд: робот тратит лимит обхода на пустые и одинаковые выборки и месяцами не доходит до товаров; «бренд + цвет» и «цвет + бренд» конкурируют между собой; релевантность категории размывается тысячами её копий. Это классический сценарий появления дублей страниц — только в промышленном масштабе.
Какие страницы фильтров открывать для индексации
Решение всегда одно и то же по форме: белый список. Открыто только то, что прошло отбор, всё остальное закрыто по умолчанию. Критериев отбора пять.
- Есть подтверждённый спрос: комбинация соответствует запросу с частотностью в Вордстате. Список берётся из семантического ядра, а не из фантазии разработчика.
- В комбинации один, максимум два параметра: «кроссовки + Nike», «кроссовки + Nike + белые». Три и больше — почти всегда нулевой спрос.
- Выдача не пустая и не совпадает с родительской категорией: страница с двумя товарами или со всем ассортиментом категории не даёт поисковику причин её ранжировать.
- У страницы свой title, description и h1 по шаблону с подстановкой значений — не копия метатегов категории.
- Адрес — человекопонятный статический URL вида /krossovki/nike/, а не хвост GET-параметров.
Практичное правило глубины: комбинации с одним параметром открываются почти все (если по ним есть хоть какой-то спрос), с двумя — выборочно по семантике, с тремя и больше — закрыты всегда.
Что закрывать и каким инструментом
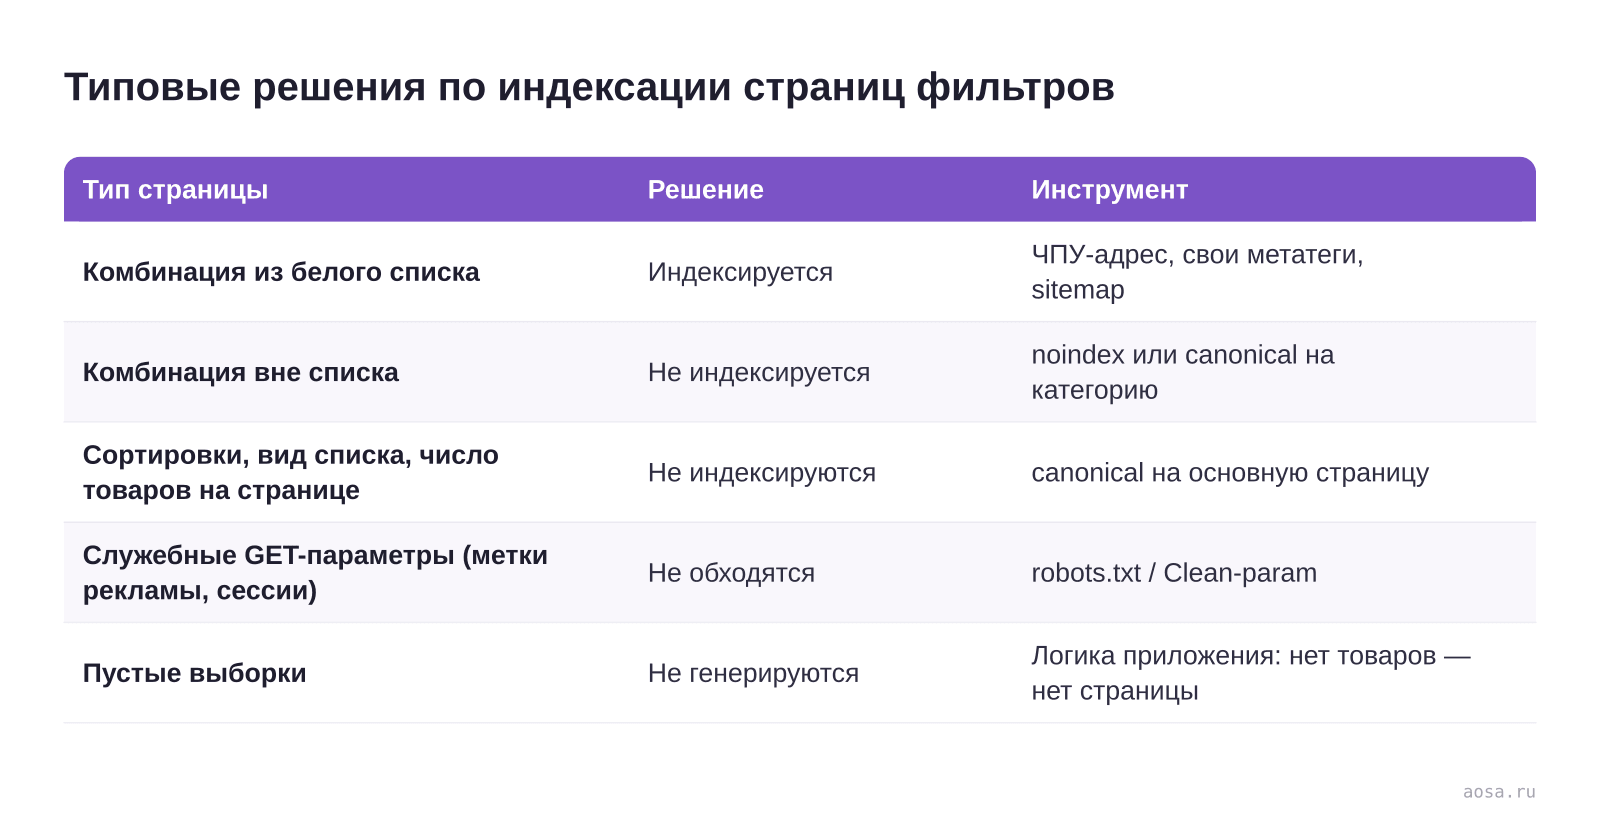
Типовые решения по индексации страниц фильтров
- Тип страницы: Комбинация из белого списка
- Решение: Индексируется
- Инструмент: ЧПУ-адрес, свои метатеги, sitemap
- Тип страницы: Комбинация вне списка
- Решение: Не индексируется
- Инструмент: noindex или canonical на категорию
- Тип страницы: Сортировки, вид списка, число товаров на странице
- Решение: Не индексируются
- Инструмент: canonical на основную страницу
- Тип страницы: Служебные GET-параметры (метки рекламы, сессии)
- Решение: Не обходятся
- Инструмент: robots.txt / Clean-param
- Тип страницы: Пустые выборки
- Решение: Не генерируются
- Инструмент: Логика приложения: нет товаров — нет страницы
Текст схемы и все данные
Типовые решения по индексации страниц фильтров
- Тип страницы: Комбинация из белого списка
- Решение: Индексируется
- Инструмент: ЧПУ-адрес, свои метатеги, sitemap
- Тип страницы: Комбинация вне списка
- Решение: Не индексируется
- Инструмент: noindex или canonical на категорию
- Тип страницы: Сортировки, вид списка, число товаров на странице
- Решение: Не индексируются
- Инструмент: canonical на основную страницу
- Тип страницы: Служебные GET-параметры (метки рекламы, сессии)
- Решение: Не обходятся
- Инструмент: robots.txt / Clean-param
- Тип страницы: Пустые выборки
- Решение: Не генерируются
- Инструмент: Логика приложения: нет товаров — нет страницы
| Тип страницы | Решение | Инструмент |
|---|---|---|
| Комбинация из белого списка | Индексируется | ЧПУ-адрес, свои метатеги, sitemap |
| Комбинация вне списка | Не индексируется | noindex или canonical на категорию |
| Сортировки, вид списка, число товаров на странице | Не индексируются | canonical на основную страницу |
| Служебные GET-параметры (метки рекламы, сессии) | Не обходятся | robots.txt / Clean-param |
| Пустые выборки | Не генерируются | Логика приложения: нет товаров — нет страницы |
Инструменты не взаимозаменяемы, и путать их — вторая по частоте ошибка после «открыть всё». Robots.txt запрещает обход, но не удаляет уже проиндексированные адреса — а страница под запретом обхода не покажет роботу и запрещающий метатег. Noindex убирает страницу из индекса, но требует, чтобы робот её посетил. Canonical — рекомендация, а не приказ: для сортировок работает, на содержательно разных выборках игнорируется. Рабочая связка: canonical для вариаций одной выдачи, noindex для комбинаций вне белого списка, robots.txt — только для технических параметров.
Что заложить на этапе разработки
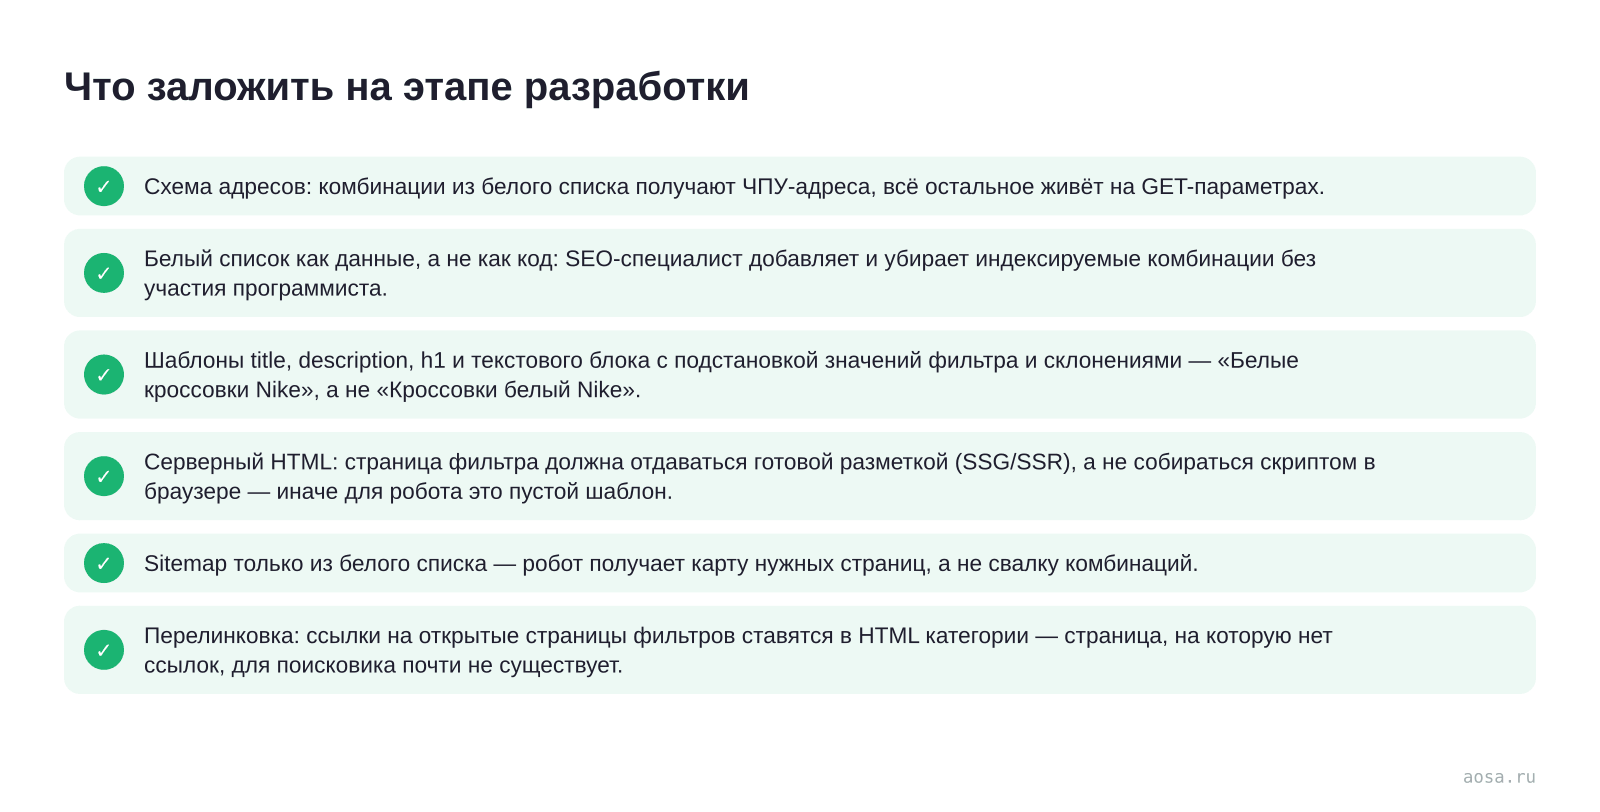
Всё перечисленное — не настройки, которые «потом докрутит сеошник». Это архитектура: схема URL, механизм белого списка и шаблоны метатегов зашиваются в код каталога, поэтому решаются до запуска — в идеале семантика собирается раньше, чем проектируется каталог.
- Схема адресов: комбинации из белого списка получают ЧПУ-адреса, всё остальное живёт на GET-параметрах.
- Белый список как данные, а не как код: SEO-специалист добавляет и убирает индексируемые комбинации без участия программиста.
- Шаблоны title, description, h1 и текстового блока с подстановкой значений фильтра и склонениями — «Белые кроссовки Nike», а не «Кроссовки белый Nike».
- Серверный HTML: страница фильтра должна отдаваться готовой разметкой (SSG/SSR), а не собираться скриптом в браузере — иначе для робота это пустой шаблон.
- Sitemap только из белого списка — робот получает карту нужных страниц, а не свалку комбинаций.
- Перелинковка: ссылки на открытые страницы фильтров ставятся в HTML категории — страница, на которую нет ссылок, для поисковика почти не существует.
Что заложить на этапе разработки
- Схема адресов: комбинации из белого списка получают ЧПУ-адреса, всё остальное живёт на GET-параметрах.
- Да
- Белый список как данные, а не как код: SEO-специалист добавляет и убирает индексируемые комбинации без участия программиста.
- Да
- Шаблоны title, description, h1 и текстового блока с подстановкой значений фильтра и склонениями — «Белые кроссовки Nike», а не «Кроссовки белый Nike».
- Да
- Серверный HTML: страница фильтра должна отдаваться готовой разметкой (SSG/SSR), а не собираться скриптом в браузере — иначе для робота это пустой шаблон.
- Да
- Sitemap только из белого списка — робот получает карту нужных страниц, а не свалку комбинаций.
- Да
- Перелинковка: ссылки на открытые страницы фильтров ставятся в HTML категории — страница, на которую нет ссылок, для поисковика почти не существует.
- Да
Текст схемы и все данные
Что заложить на этапе разработки
- Схема адресов: комбинации из белого списка получают ЧПУ-адреса, всё остальное живёт на GET-параметрах.
- Да
- Белый список как данные, а не как код: SEO-специалист добавляет и убирает индексируемые комбинации без участия программиста.
- Да
- Шаблоны title, description, h1 и текстового блока с подстановкой значений фильтра и склонениями — «Белые кроссовки Nike», а не «Кроссовки белый Nike».
- Да
- Серверный HTML: страница фильтра должна отдаваться готовой разметкой (SSG/SSR), а не собираться скриптом в браузере — иначе для робота это пустой шаблон.
- Да
- Sitemap только из белого списка — робот получает карту нужных страниц, а не свалку комбинаций.
- Да
- Перелинковка: ссылки на открытые страницы фильтров ставятся в HTML категории — страница, на которую нет ссылок, для поисковика почти не существует.
- Да
Цена ошибки измеряется месяцами. Сменить схему URL после запуска — это переезд: редиректы, переобход, временная просадка. Вычистить из индекса сотни тысяч мусорных комбинаций — месяцы, пока роботы переварят noindex. Мы в АОСА поэтому проектируем интернет-магазины от семантики: сначала ядро и белый список комбинаций, потом структура каталога и код — как это выглядит на практике, разбирали в статье о технологиях сайта.
Расчёт условный, для иллюстрации порядка величин. Магазин с 40 категориями: семантика подтверждает спрос в среднем на 12–15 комбинаций фильтров на категорию плюс 3–5 теговых страниц. Итого 600–800 посадочных страниц под низкочастотные запросы — против десятков миллионов технически возможных комбинаций. Открыть эти сотни и закрыть всё остальное — и есть суть архитектуры SEO-фильтра; как распределяется спрос по типам страниц, мы разбирали в гайде по SEO для интернет-магазина.
Собирательный пример на основе типовых проектов — не реальный клиент.
Самый дорогой вариант этой задачи — «решим после запуска». После запуска выясняется, что у фильтров нет адресов, либо наоборот: в индексе сотни тысяч комбинаций, и «малоценных» страниц в Вебмастере больше, чем товаров. Дальше два пути, оба долгие: менять маршрутизацию с редиректами или месяцами вычищать индекс. На этапе проектирования та же работа занимает дни. Поэтому один вопрос разработчику до старта обязателен: «Покажите, как в каталоге управляется индексация комбинаций фильтров». Если ответа нет — архитектуру будете переделывать вы.
Владимир БогдановОснователь и руководитель AOSA · эксперт по SEO и AEO, 12+ лет в поисковой оптимизации