

Строка поиска на сайте может создавать новый URL для каждого запроса, фильтра или сортировки. В документации Google предупреждает: большое число похожих адресов усложняет обход. Для проблемных URL поисковик предлагает рассмотреть ограничения в robots.txt.
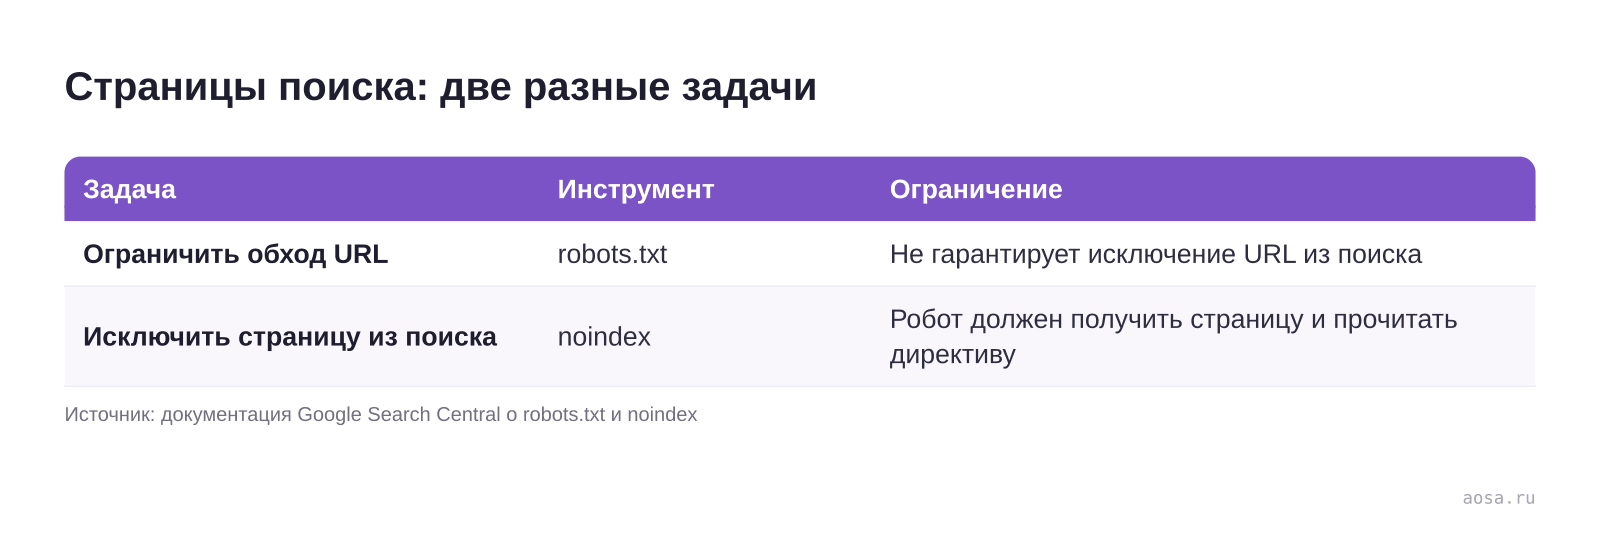
Страницы поиска: две разные задачи
- Задача: Ограничить обход URL
- Инструмент: robots.txt
- Ограничение: Не гарантирует исключение URL из поиска
- Задача: Исключить страницу из поиска
- Инструмент: noindex
- Ограничение: Робот должен получить страницу и прочитать директиву
Источник: документация Google Search Central о robots.txt и noindex
Текст схемы и все данные
Страницы поиска: две разные задачи
- Задача: Ограничить обход URL
- Инструмент: robots.txt
- Ограничение: Не гарантирует исключение URL из поиска
- Задача: Исключить страницу из поиска
- Инструмент: noindex
- Ограничение: Робот должен получить страницу и прочитать директиву
Источник: документация Google Search Central о robots.txt и noindex
robots.txt регулирует доступ робота к странице, но сам по себе не гарантирует удаления её адреса из выдачи. Для исключения страницы используют noindex. Google должен получить страницу и прочитать эту директиву: если обход запрещён в robots.txt, он её не увидит.
Начните с проверки фактических адресов внутреннего поиска в отчёте об индексировании и логах сервера. Отделите пустые результаты, произвольные запросы и комбинации фильтров от страниц, которые действительно помогают выбрать товар или услугу. Правила задавайте для конкретных типов URL и проверяйте на примерах.
Если подборка нужна как самостоятельная посадочная, оцените её содержание и устойчивость URL отдельно. Открытие всех результатов поиска не заменяет создание полезных категорий.
Редакционное уточнение от 5 октября 2026 года: материал впервые опубликован 3 августа после сообщений об обсуждении внутреннего поиска в подкасте Google. При обновлении убрали неподтверждённую точную дату отмены старого правила; рекомендации выше сверены с документацией Google.
Источники: Google Search Central — структура URL, исключение страницы с помощью noindex, назначение robots.txt.
Сначала определите цель: уменьшить лишний обход или убрать страницу из поиска. Затем выбирайте правило и проверяйте, видит ли робот именно тот ответ, который вы запланировали.
Источник: developers.google.com