

Сбер анонсировал новое поколение своих языковых моделей — GigaChat 2.0, флагманом которого стала версия MAX. По заявлению компании, в независимых тестах модель оказалась сопоставима с GPT-4o и DeepSeek-V3, причём наиболее заметное преимущество разработчики отмечают именно на русскоязычных задачах. Это логичный шаг в развитии отечественных больших языковых моделей, которые за последние два года прошли путь от закрытых тестов до полноценных инструментов для бизнеса.
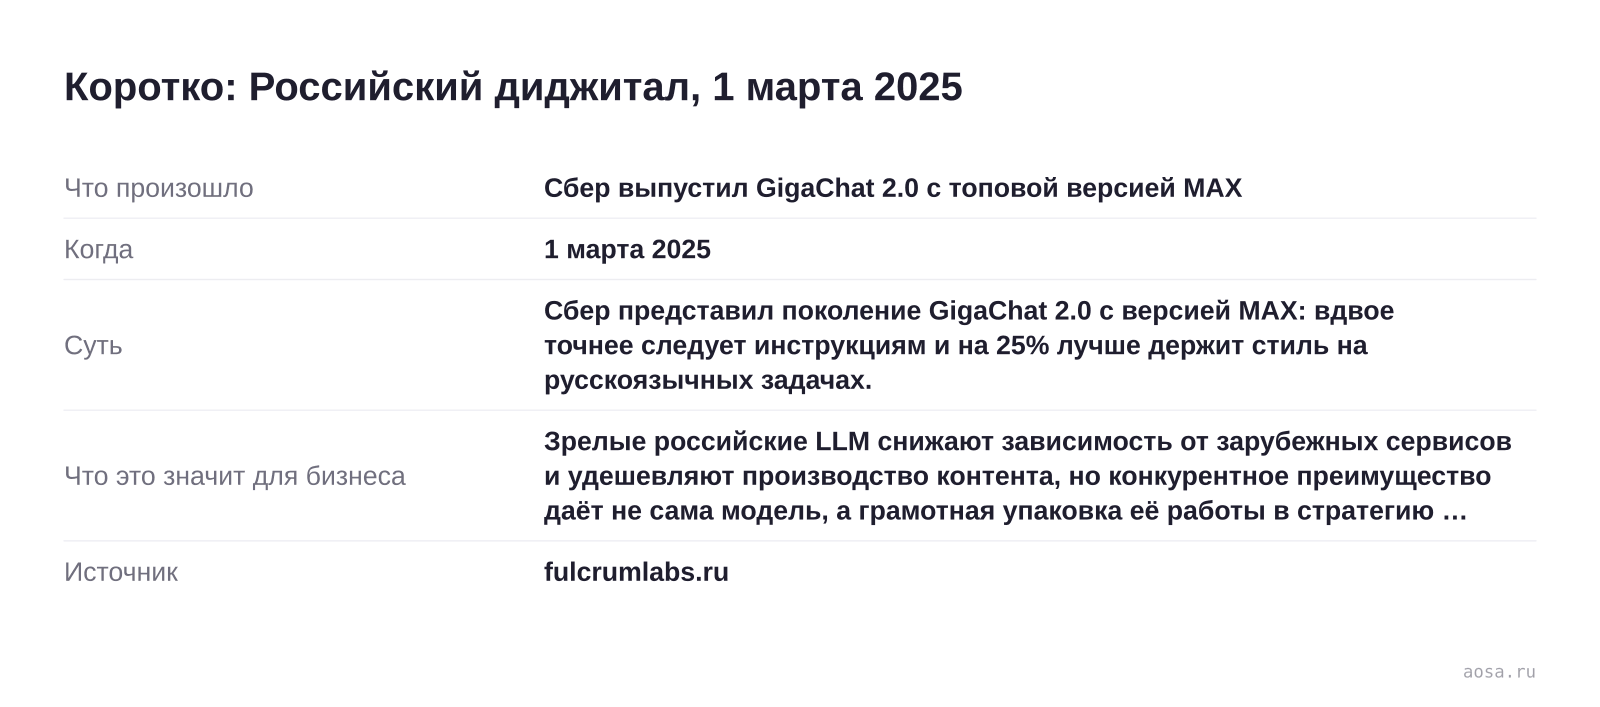
Коротко: Российский диджитал, 1 марта 2025
- Что произошло
- Сбер выпустил GigaChat 2.0 с топовой версией MAX
- Когда
- 1 марта 2025
- Суть
- Сбер представил поколение GigaChat 2.0 с версией MAX: вдвое точнее следует инструкциям и на 25% лучше держит стиль на русскоязычных задачах.
- Что это значит для бизнеса
- Зрелые российские LLM снижают зависимость от зарубежных сервисов и удешевляют производство контента, но конкурентное преимущество даёт не сама модель, а грамотная упаковка её работы в стратегию — здесь помогает контент на нейросетях под контролем редакторов.
- Источник
- fulcrumlabs.ru
Текст схемы и все данные
Коротко: Российский диджитал, 1 марта 2025
- Что произошло
- Сбер выпустил GigaChat 2.0 с топовой версией MAX
- Когда
- 1 марта 2025
- Суть
- Сбер представил поколение GigaChat 2.0 с версией MAX: вдвое точнее следует инструкциям и на 25% лучше держит стиль на русскоязычных задачах.
- Что это значит для бизнеса
- Зрелые российские LLM снижают зависимость от зарубежных сервисов и удешевляют производство контента, но конкурентное преимущество даёт не сама модель, а грамотная упаковка её работы в стратегию — здесь помогает контент на нейросетях под контролем редакторов.
- Источник
- fulcrumlabs.ru
Из метрик, которые приводит Сбер, для практиков важны две: GigaChat 2.0 вдвое точнее следует инструкциям и примерно на 25% лучше выдерживает запрошенный стиль ответа. На первый взгляд это технические детали, но именно от них зависит, насколько модель пригодна для production-задач — генерации описаний, ответов поддержки, типизированных текстов по шаблону. Чем точнее модель держит инструкцию и тон, тем меньше ручной правки и тем предсказуемее результат при потоковом производстве контента на нейросетях.
Усиление российских LLM меняет расстановку сил на рынке. Раньше у бизнеса, ориентированного на рунет, выбор сводился к зарубежным моделям с их ограничениями по доступу и оплате либо к заметно более слабым локальным аналогам. Теперь GigaChat 2.0 и YandexGPT формируют зрелую отечественную альтернативу, на которой можно строить рабочие процессы без оглядки на санкционные и инфраструктурные риски.
Для SEO и контент-команд это не абстрактная новость. Качество русскоязычной генерации напрямую влияет на то, как материалы воспринимаются и поисковыми алгоритмами, и самими нейросетями. По мере того как нейропоиск становится самостоятельным каналом, важно понимать, какие модели стоят за ответами и на каких данных они обучены — это определяет, как нейросети отбирают источники для своих ответов.
При этом мощная генеративная модель — лишь инструмент. Сам факт доступа к GigaChat 2.0 не гарантирует ни роста трафика, ни попадания в выдачу нейросетей. Текст всё так же должен соответствовать требованиям E-E-A-T, нести экспертизу и решать задачу пользователя, а не просто быть гладко сгенерированным. Мы в AOSA рассматриваем такие модели как ускоритель производства, а не как замену редактуре и стратегии.
Зрелые российские LLM снижают зависимость от зарубежных сервисов и удешевляют производство контента, но конкурентное преимущество даёт не сама модель, а грамотная упаковка её работы в стратегию — здесь помогает контент на нейросетях под контролем редакторов.
Источник: fulcrumlabs.ru