

Китайская команда DeepSeek выпустила DeepSeek-V3 — открытую языковую модель с архитектурой MoE (Mixture-of-Experts) на 671 млрд параметров, из которых при обработке каждого запроса активны лишь около 37 млрд. По собственным бенчмаркам компании, модель вплотную подошла к качеству GPT-4 и Claude 3.5 Sonnet, оставаясь при этом одной из сильнейших открытых разработок на рынке. Главная сенсация — экономика: финальное обучение, по оценкам DeepSeek, обошлось примерно в 5,5 млн долларов, что на порядок ниже бюджетов западных флагманов.
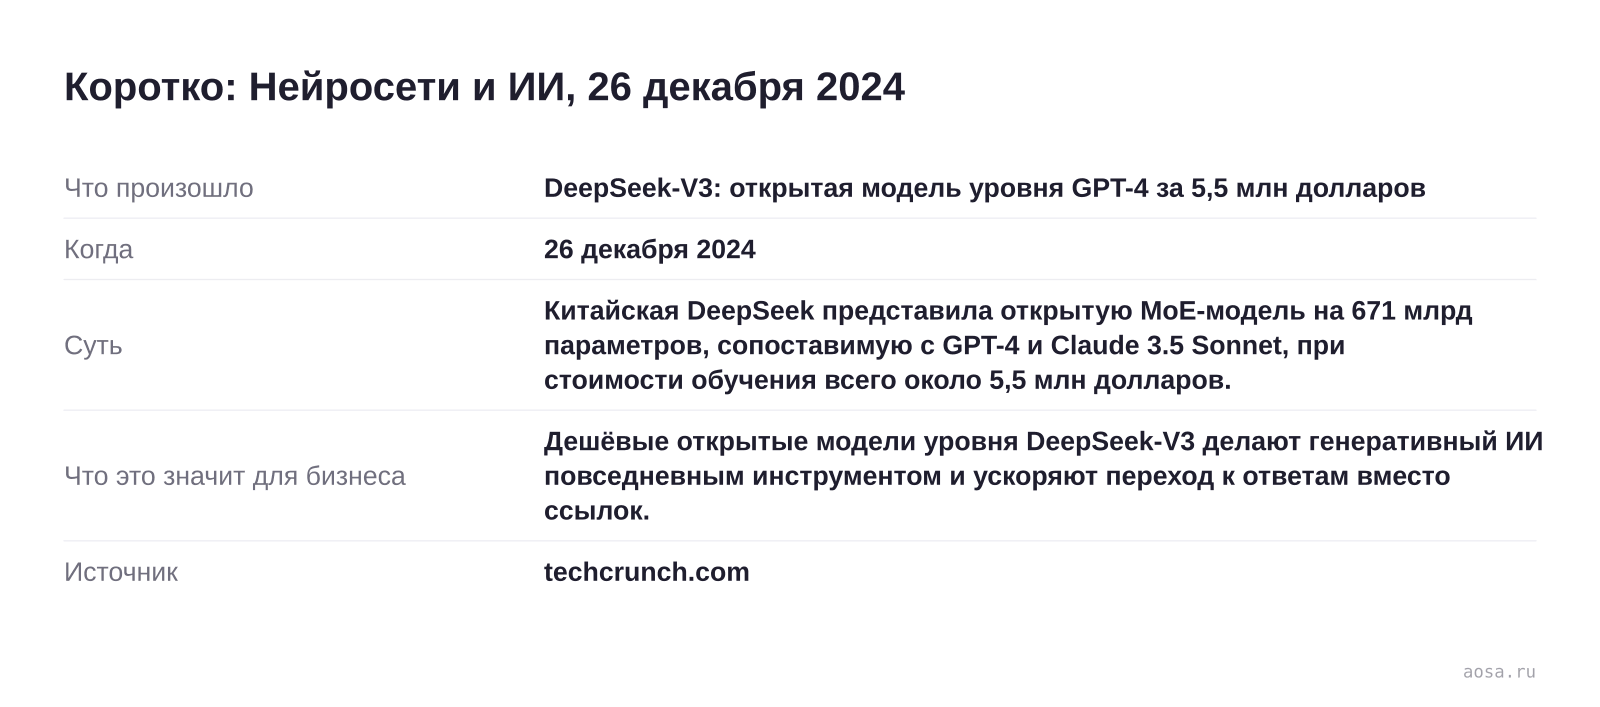
Коротко: Нейросети и ИИ, 26 декабря 2024
- Что произошло
- DeepSeek-V3: открытая модель уровня GPT-4 за 5,5 млн долларов
- Когда
- 26 декабря 2024
- Суть
- Китайская DeepSeek представила открытую MoE-модель на 671 млрд параметров, сопоставимую с GPT-4 и Claude 3.5 Sonnet, при стоимости обучения всего около 5,5 млн долларов.
- Что это значит для бизнеса
- Дешёвые открытые модели уровня DeepSeek-V3 делают генеративный ИИ повседневным инструментом и ускоряют переход к ответам вместо ссылок.
- Источник
- techcrunch.com
Текст схемы и все данные
Коротко: Нейросети и ИИ, 26 декабря 2024
- Что произошло
- DeepSeek-V3: открытая модель уровня GPT-4 за 5,5 млн долларов
- Когда
- 26 декабря 2024
- Суть
- Китайская DeepSeek представила открытую MoE-модель на 671 млрд параметров, сопоставимую с GPT-4 и Claude 3.5 Sonnet, при стоимости обучения всего около 5,5 млн долларов.
- Что это значит для бизнеса
- Дешёвые открытые модели уровня DeepSeek-V3 делают генеративный ИИ повседневным инструментом и ускоряют переход к ответам вместо ссылок.
- Источник
- techcrunch.com
Подход MoE как раз и объясняет это сочетание мощности и дешевизны. Вместо того чтобы прогонять каждый запрос через все параметры, модель активирует только нужную часть «экспертов», резко снижая стоимость вычислений без потери качества ответа. В паре с permissive-лицензией это означает, что бизнес впервые получает модель уровня топовых проприетарных систем, которую можно развернуть у себя, дообучить под свои данные и не платить за каждый токен внешнему провайдеру. Для понимания, почему это меняет правила игры, полезно разобраться в самой механике больших языковых моделей (LLM).
Для нашей отрасли важна не отдельная модель, а тренд, который она задаёт: мощный ИИ становится массовым и дешёвым. Чем доступнее LLM, тем быстрее они встраиваются в поисковые сценарии — от нейропоиска до ассистентов, которые отдают пользователю готовый ответ вместо списка ссылок. Меняется и распределение трафика: всё больше запросов завершается прямо в чате, а бренд попадает в поле зрения, только если модель сочла его контент достойным цитирования. О том, как нейросети меняют трафик, мы пишем подробно — и DeepSeek-V3 лишь ускоряет эту динамику.
Удешевление вычислений имеет и обратную сторону. Дешёвые открытые модели снижают порог для массовой генерации текстов, и поисковики на это уже реагируют — достаточно вспомнить ужесточение фильтров против неоригинального и шаблонного контента. Поэтому ставка на объём теряет смысл: ценность приобретает контент, который ИИ-системы готовы взять в источник, — фактически точный, структурированный, с понятной экспертизой и корректной Schema-разметкой. Это переносит часть задач из классического SEO-продвижения в плоскость работы с генеративными ответами.
Практический шаг для бизнеса — не пытаться обыграть ИИ объёмом, а готовить сайт к тому, чтобы его цитировали. Мы рекомендуем выстраивать оптимизацию под нейропоиск (AEO) системно и заранее понимать, какие сайты нейросети берут в источники, а не догонять конкурентов, когда место в ИИ-ответах уже занято. Релиз DeepSeek-V3 логично рассматривать в одном ряду с семейством Claude 3 и другими событиями 2024 года: все они подталкивают рынок к одному — ответы всё чаще генерируются, а не находятся.
Дешёвые открытые модели уровня DeepSeek-V3 делают генеративный ИИ повседневным инструментом и ускоряют переход к ответам вместо ссылок. Выигрывают бренды с точным структурированным контентом, который модели цитируют, — закладывать оптимизацию под нейропоиск (AEO) стоит уже сейчас.
Источник: techcrunch.com